
OpenAI też nie próżnuje – niemal równocześnie z Opusem startup wypuścił GPT-6 Sol i Luna, choć tu postępy nie są aż tak imponujące. Jest jeszcze jedna dobra wiadomość – nowe modele są tańsze od poprzedników.
12 września, w cztery dni po odejściu z Anthropica Jacoba Coxona, który krytykował czołowe laby AI za skupianie się na wyścigu ze sobą i z globalną konkurencją bardziej niż na bezpieczeństwie, szef Anthropica Dario Amodei opublikował esej „We Must Pace the Frontier” – „musimy kontrolować tempo rozwoju czołowych modeli”. Nie zahamować rozwój, ale utrzymywać go w takim tempie, by zabezpieczenia zdążyły nadążyć za rosnącymi możliwościami AI.
Na HomoDigital pisaliśmy o tym tu: Wyścig AI zaczyna hamować. Altman, Amodei i Microsoft mówią o granicach
Nie minęły dwa tygodnie, a otrzymaliśmy Claude Opus 5.5 – najnowsze dzieło Anthropica. Lepsze, jeśli wierzyć benchmarkom Artificial Analysis, od Fable i GPT-6 Astra. Oczywiście, w momencie ogłaszania eseju przez Amodeiego Opus 5.5 był zapewne w fazie ostatnich testów a nie aktywnie rozwijanym modelem. Ale fakt, że Anthropic wypuszcza nowy model bijący na głowę konkurencję (w tym wewnętrzną) i to w niecałe dwa miesiące po poprzedniej wersji Opus oraz w trzy tygodnie po ostatniej wersji Fable – 5.1 – jest w jakimś sensie symboliczny.
Opus 5.5 – jest lepiej
Jak dobry jest Opus 5.5? Wystarczająco dobry, by OpenAI powróciło do swojej normy z ostatnich miesięcy, czyli do oglądania pleców Anthropica. Przynajmniej na razie.
Konkretnie, najnowszy Opus uzyskał w syntetycznym benchmarku Artificial Analysis Intelligence Index 58 punktów, a więc o 5 więcej niż Fable 5.1 i GPT-6 Astra. Syntetyczne benchmarki tradycyjnie przesłaniają niuanse, więc spójrzmy na szczegóły:
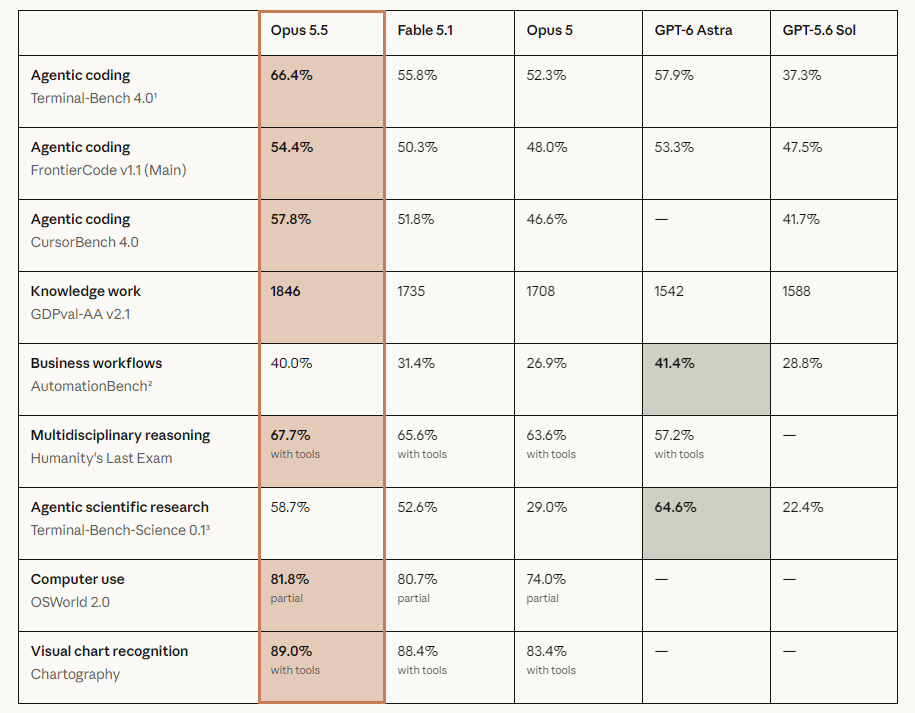
Jak widać z tabelki dostarczonej przez Anthropica, dla firmy w ewaluacji modeli przestały się w dużej mierze liczyć benchmarki z matematyki, nauk ścisłych i tym podobne. Najważniejsze są zdolności agentowe, zastosowania biznesowe i użycie komputera. Z tradycyjnych benchmarków mierzących umiejętności naukowe został nam Humanity’s Last Exam.
W tej nowej rzeczywistości benchmarkowej Opus 5.5 radzi sobie bardzo dobrze. Prowadzi w siedmiu z dziewięciu kategorii, oddając palmę pierwszeństwa GPT-6 Astra tylko w dwóch: AutomationBench, mierzącej zastosowania biznesowe, i Terminal-Bench-Science, mierzącej agentowe badania naukowe. To od pewnego czasu były bardzo mocne strony modeli OpenAI.
Opus 5.5 – i jest taniej
To niejedyna dobra wiadomość dla użytkowników AI od Anthropica. Firma, której wysokie ceny stały się jednym z ulubionych tematów krytyki ze strony użytkowników AI, w końcu postanowiła trochę ulżyć swoim klientom.
Jak pisze firma, „obsługa Opusa 5.5 wymaga mniej mocy obliczeniowej niż Opusa 5, co przekłada się na jego [niższą] cenę”.
Ta „obniżka” w przypadku klientów płacących subskrypcję niestety nie oznacza niższych cen abonamentu. Te pozostaną na dotychczasowych poziomach. Jednak podniesiono bieżące limity użycia, które bywają bolesne, zwłaszcza dla osób często korzystających z Coworka do pracy na przykład nad plikami. Mnie już kilkukrotnie zdarzyło się, że musiałem przejść na model Sonnet, bo limity bieżące – resetujące się co 5 godzin – były bliskie wyczerpania i na dokończenie przy użyciu Opusa musiałbym czekać jakieś 3 godziny. Opus 5.5 będzie „przejadał” nasze limity wolniej. Plus dostajemy darmowy „reset” limitów – na awaryjną sytuację, gdy robota nie może czekać.
Ci, którzy używają Opusa do kodowania czy do automatyzacji przez API zapłacą o 20% mniej niż za poprzednią wersję – o tyle mniej będą kosztować tokeny (konkretnie 4 dolary za milion tokenów wejściowych i 20 dolarów za milion wyjściowych). A ponieważ model jest „zdolniejszy”, to Anthropic szacuje, że ogólny koszt spadnie o 40%.
Dla korzystających z API szczególnie atrakcyjne wydaje się używanie Opusa 5.5 na poziomie „high” wysiłku modelu, a więc na środkowym poziomie w skali Anthropica. Na tym poziomie Opus 5.5 osiąga 54 pkt w AA Intelligence Index, a więc co prawda 4 punkty mniej niż ten sam model na poziomie „max”, ale za to więcej niż dla Fable. I to przy atrakcyjnej cenie – według pomiarów Artificial Analysis, cena za zadanie to 1,82 dolara, w porównaniu z niemal 6 dolarami dla wysiłku „max” i przeszło 7,6 dolara dla najmocniejszego Fable.
GPT-6 Sol i Luna – jest głównie taniej
Na tle Opus 5.5 nieco bardziej blado wypada premiera GPT-6 Sol i Luna. Sol 6 jest tylko minimalnie lepszy od poprzednika z numerem 5.6 (AAII 48 pkt vs 47 pkt), a jego główną przewagą jest cena. Luna 6 pozostała na tym samym poziomie AAII co jej poprzedniczka (raptem 37 pkt), ale i tu cena solidnie spadła.
To nie tylko kwestia doboru benchmarków na Artificial Analysis – jeśli uważnie spojrzymy na wykresy na komunikacie prasowym OpenAI o udostępnieniu nowych modeli, to zauważymy, że, zwłaszcza w przypadku Luny, postępy dotyczą głównie ceny zadania, a nie osiągnięć modelu w danej dziedzinie.
Ale redukcja ceny jest istotnie bardziej imponująca niż w przypadku Anthropica – oba modele w najnowszej wersji staniały o około 50%. Sol kosztuje teraz 2 dolary za milion tokenów wejściowych i 10 dolarów za milion wyjściowych. To są ceny jak dla Claude Sonnet 5 – modelu o znacznie mniejszych możliwościach, porównywalnych z Luną a nie z Sol.
Ceny Opus 5.5 i GPT-6 niższe, bo konkurencja rośnie?
Skąd te obniżki cen u dwóch czołowych labów AI? Anthropic wspomina o wyższej wydajności modelu, ale to zapewne tylko część prawdy. Druga część to fakt, że modele osiągnęły już taki poziom umiejętności, że do wielu zastosowań modele lepsze ale droższe nie są nikomu potrzebne – liczy się przede wszystkim cena.
Z tego trendu najwyraźniej postanowił skorzystać Google. Choć firma wciąż zmaga się z wypuszczeniem kolejnej wersji swojego flagowca Gemini Pro (ostatnia wersja 3.1 ma już bardzo długą brodę), podobno zaniechała prac nad wersjami 3.x i teraz skupia się na modelu Gemini 4 Pro (ma się ukazać „istotnie” przed końcem roku 2026), to w międzyczasie wypuszcza z dużą częstotliwością mniejsze modele Flash. Tu Google miał istotne osiągnięcia – w niektórych wąskich, powtarzalnych działaniach agentowych model Gemini 3.8 Flash zbliżył się do modeli Opus czy Sol albo je wyprzedził, i to za ułamek ich ceny. Ale w bardziej ogólnym benchmarku AAII osiągnął raptem 41 pkt – wyraźnie mniej niż Opus i Sol, bliżej Sonnet 5 czy Luny.
Konkurencję dla Anthropica i OpenAI stanowią też chińskie laby AI – te wypuszczają wagi swoich modeli zwykle za darmo, więc ich cena to często tylko cena zużytych mocy obliczeniowych w chmurze.
Firmy Amodei i Altmana oczywiście mogą sobie pozwolić na wyższe ceny niż u konkurencji – ich modele są po prostu lepsze a władze amerykańskie niechętnie patrzą na użycie przez lokalne firmy modeli chińskich. Ale jak widać istnieją granice tej swoistej fosy – i obie firmy najwyraźniej doszły do wniosku, że lepiej jest zejść trochę z ceną niż oddawać udziały rynkowe.
Jak to jest z tym spowolnieniem?
Jak to więc jest z tym kontrolowanym tempem rozwoju czołowych modeli (z założenia takich jak Fable/Mythos i Astra) , jeśli najlepszym modelem jest ich nieco mniejszy brat Opus?
Na pewno na odpowiedź trochę poczekamy – deklaracje Amodeiego mają niecałe dwa tygodnie, a trenowanie modeli trwa miesiące. Więc jeśli zobaczymy spowolnienie, to za ładnych kilka tygodni lub miesięcy.
Ale ryzyk dla tych deklaracji jest sporo. Po pierwsze nie do końca wiemy jakie są motywacje Amodeiego, Altmana czy Muska – i czy faktycznie są szlachetne.
Po drugie wiele zależy od poziomu zaufania między firmami – a z tym jest problem. Stosunki między Anthropikiem a OpenAI, czy między OpenAI a Muskiem są, delikatnie mówiąc, chłodne, a o zaufaniu (jak widać choćby po pozwie Muska przeciw OpenAI) raczej nie ma mowy. O tym braku zaufania mówił Coxon gdy odchodził z Anthropica – według niego firma rozumie ryzyko, ale usprawiedliwia swój udział w wyścigu AI brakiem zaufania do innych.
No i wreszcie dochodzi czynnik chiński. Władze chińskie odrzuciły deklarację Amodeiego, zwłaszcza że wezwał do wprowadzenia większych restrykcji na chińską AI. A według ostatniego badania Mozilli, modele otwarte (czytaj: chińskie) są tylko nieco ponad cztery miesiące za zamkniętymi (czytaj: większość amerykańskich). To zaś oznacza, nawet jeśli Fundacja Mozilla myli się o miesiąc czy dwa, że lada chwila możemy zobaczyć chiński model o umiejętnościach Mythosa/Fable.
Czemu to tak ważne? Bo te modele znacząco przyspieszają budowę kolejnych modeli, nawet jeśli nie potrafią jeszcze samodzielnie zaprojektować następcy.
Chodzi tu o tak zwane rekurencyjne samodoskonalenie modeli (RSI, od ang. recursive self-improvement). Częściowe RSI, de facto już możliwe w przypadku Mythosa, polega na tym, że AI przyspiesza budowę kolejnej generacji AI. Pełne RSI, w którym model samodzielnie projektuje i trenuje swojego następcę, jeszcze nie istnieje.
Problem polega na tym, że jeśli Chińczycy doszliby do choćby częściowego, nie mówiąc o pełnym RSI, a amerykańskie laby by spowolniły swój rozwój ze względu na obawy o bezpieczeństwo, to na świecie i tak mielibyśmy niebezpieczną AI – tyle że chińską. I to lepszą od amerykańskiej. Czego na pewno nie chce ani Anthropic, ani OpenAI, ani Elon Musk, ani amerykański rząd. I czego raczej nie powinien chcieć cały zachodni świat.
Jest więc spora szansa, że skończy się na wpuszczeniu do labów AI zewnętrznych testerów modeli, co już wprowadził Amodei a zapowiedziało OpenAI. To może trochę opóźni wypuszczanie modeli – ale raczej o tygodnie niż miesiące. A modele będą wypuszczane z podobną częstością – po prostu ich cykl produkcyjny nieco się wydłuży. To tym bardziej prawdopodobne, że już w ocenie Opus 5.5 brali udział zewnętrzni testerzy, a model ukazał się raptem dwa miesiące po poprzedniku.
Źródło grafiki: Sztuczna inteligencja, ChatGPT


 0 komentarzy